Deep learning vs. machine learning: ¿en qué se diferencian?

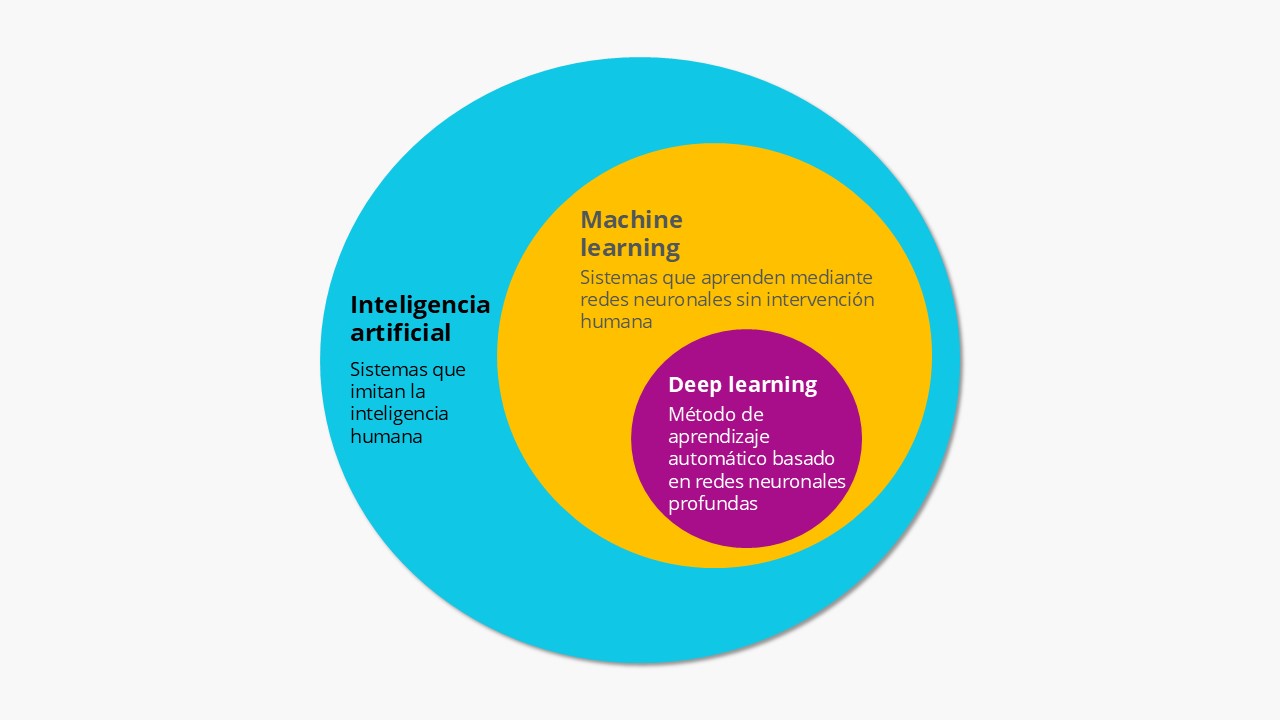
El aprendizaje automático y el aprendizaje profundo permiten que los sistemas de IA aprendan a partir de datos y reconozcan patrones. La principal diferencia entre el aprendizaje automático y el aprendizaje profundo es que el primero engloba distintos métodos y tipos de modelos, como la regresión, los árboles de decisión, las máquinas de vectores de soporte o las redes neuronales. El aprendizaje profundo, en cambio, se basa específicamente en redes neuronales profundas formadas por múltiples capas.
Resumen
- Las redes neuronales procesan la información a través de una capa de entrada, capas ocultas y una capa de salida.
- El aprendizaje automático permite que los sistemas aprendan a partir de datos y reconozcan patrones sin necesidad de programar explícitamente todas las reglas.
- El aprendizaje profundo es una rama específica del aprendizaje automático que utiliza redes neuronales artificiales con múltiples capas de procesamiento.
- Las diferencias principales se encuentran en el formato de datos, el volumen de datos, la selección de características, la estructura del modelo, los recursos necesarios y el campo de aplicación.
- El aprendizaje automático y el aprendizaje profundo se utilizan, por ejemplo, en el marketing en línea, la atención al cliente y la inteligencia empresarial.
Deep learning vs. machine learning: ¿cuál es la diferencia entre el aprendizaje automático y el aprendizaje profundo?
Tanto el aprendizaje automático como el aprendizaje profundo forman parte de la inteligencia artificial. Ambos enfoques se basan en métodos con los que se entrenan sistemas de IA para procesar datos, reconocer patrones y ajustar sus modelos con el fin de realizar predicciones o tomar decisiones. En este contexto, el aprendizaje profundo es una rama del aprendizaje automático que utiliza redes neuronales de múltiples capas.
- Una plataforma diseñada para los modelos de IA más potentes
- Precios justos y transparentes basados en tokens
- Open source, sin vendor lock-in
Redes neuronales
Para entender mejor la diferencia entre el aprendizaje automático y el aprendizaje profundo, conviene conocer primero cómo funcionan las redes neuronales. Las redes neuronales son modelos computacionales cuya arquitectura se inspira de forma general en el funcionamiento del cerebro humano. Están formadas por numerosas unidades de cálculo interconectadas que procesan la información a través de distintas capas. Por lo general, se distinguen tres tipos:
- Capa de entrada (input layer): recibe los datos que debe procesar la red.
- Capas ocultas (hidden layers): procesan la información y extraen patrones y características relevantes.
- Capa de salida (output layer): proporciona el resultado final.
La capa de entrada y la capa de salida marcan el principio y el final de la red neuronal. Entre ellas se encuentran las denominadas capas ocultas, que pueden presentar estructuras muy diferentes. Los modelos sencillos pueden contar con una o pocas capas ocultas, mientras que las redes neuronales profundas pueden incorporar numerosas capas y un número de parámetros que puede llegar a cientos de miles de millones o incluso superar el billón. Cada capa realiza determinadas operaciones con la información recibida y transmite el resultado a las siguientes.
Estas capas pueden entenderse como distintos niveles de procesamiento. A medida que la información atraviesa la red, pueden aprenderse representaciones cada vez más complejas. En una red destinada al reconocimiento de imágenes, por ejemplo, determinadas capas pueden detectar características sencillas como líneas o bordes, mientras que otras combinan esa información para identificar formas y estructuras más complejas, como ojos, orejas o pelo.
Durante el entrenamiento, se ajustan los parámetros de la red, incluidos los pesos de las conexiones, para reducir progresivamente los errores en sus resultados. De este modo, por ejemplo, un sistema puede aprender a distinguir si en una imagen aparece un perro o un gato.
Aprendizaje automático
El término “machine learning” significa aprendizaje automático. Se trata de un ámbito de la inteligencia artificial en el que un sistema no necesita recibir todas las reglas programadas explícitamente. En su lugar, se entrena con datos para aprender patrones y relaciones que posteriormente puede utilizar para clasificar nuevos datos, realizar predicciones o apoyar la toma de decisiones.
El aprendizaje automático puede utilizar distintos métodos, como árboles de decisión, modelos de regresión, máquinas de vectores de soporte o redes neuronales. Los métodos tradicionales suelen emplearse en tareas en las que los datos son relativamente manejables y las características relevantes pueden seleccionarse o prepararse previamente.
Aprendizaje profundo
El aprendizaje profundo es una rama específica del aprendizaje automático. También en este caso se entrena un sistema con datos para que aprenda patrones y pueda procesar información nueva. La principal diferencia es que el aprendizaje profundo utiliza redes neuronales artificiales con múltiples capas de procesamiento, capaces de aprender representaciones cada vez más complejas de los datos.
No existe un número mínimo de capas que determine cuándo una red neuronal puede considerarse “profunda”. El término se utiliza de forma general para redes que cuentan con varias capas de procesamiento y cuya arquitectura permite aprender representaciones jerárquicas de los datos.
Una de las principales ventajas del aprendizaje profundo es que puede aprender automáticamente muchas de las características relevantes a partir de sus propios datos. En métodos clásicos de aprendizaje automático, estas características suelen seleccionarse o prepararse con mayor frecuencia de antemano. Por eso, el aprendizaje profundo resulta especialmente adecuado para tareas complejas y grandes volúmenes de datos, por ejemplo, para el reconocimiento de imágenes, el reconocimiento de voz, la traducción automática o la IA generativa. Sin embargo, gracias a los modelos preentrenados y al aprendizaje por transferencia (transfer learning), también puede utilizarse de forma eficaz con conjuntos de datos más pequeños y especializados, ya que los conocimientos adquiridos previamente pueden aprovecharse y adaptarse a nuevas tareas.
Resumen de las diferencias entre aprendizaje profundo y aprendizaje automático
| Aprendizaje automático | Aprendizaje profundo | |
|---|---|---|
| Formato de datos | Suele utilizarse con datos estructurados, por ejemplo tablas o valores de medición. | Resulta especialmente adecuado para datos no estructurados, como imágenes, voz o textos. |
| Volumen de datos | A menudo puede funcionar con conjuntos de datos pequeños o medianos. | El entrenamiento desde cero suele requerir grandes volúmenes de datos. |
| Selección de características | Las características relevantes suelen seleccionarse o prepararse previamente. | Puede aprender automáticamente muchas características relevantes durante el entrenamiento. |
| Estructura del modelo | Puede utilizar distintos métodos, como árboles de decisión, modelos de regresión, máquinas de vectores de soporte o redes neuronales. | Utiliza redes neuronales profundas con múltiples capas. |
| Recursos necesarios | Por lo general, requiere menos capacidad de cálculo y puede ser más sencillo de implementar. | Por lo general, requiere más capacidad de cálculo y puede ser más complejo de implementar. |
| Campo de aplicación | Muy adecuado para tareas claramente definidas, especialmente con datos estructurados. | Muy adecuado para tareas complejas como el reconocimiento de imágenes, el reconocimiento de voz o la IA generativa. |
Diferentes ámbitos de aplicación
Marketing en línea
En el ámbito del marketing en línea, las empresas utilizan herramientas de analítica basadas en aprendizaje automático para analizar los datos disponibles y realizar predicciones sobre qué tipo de contenido genera más conversiones, qué contenidos interesan más a los clientes o qué canales de marketing conducen con mayor frecuencia a una compra.
Atención al cliente
Los chatbots de atención al cliente también pueden utilizar aprendizaje automático y aprendizaje profundo. Los chatbots más sencillos suelen funcionar mediante reglas fijas, palabras clave o árboles de decisión. Reconocen determinados términos en una consulta y guían a los usuarios paso a paso hasta una respuesta adecuada.
Los chatbots de IA modernos, en cambio, utilizan con frecuencia procesamiento del lenguaje natural, grandes modelos de lenguaje y técnicas de aprendizaje profundo. Estos modelos suelen desarrollarse en varias fases: tras un amplio preentrenamiento pueden someterse a un ajuste fino y a otros procesos de adaptación para adecuar mejor sus respuestas al ámbito de aplicación correspondiente. De este modo, pueden procesar el lenguaje natural, reconocer relaciones dentro de las consultas y responder con mayor flexibilidad a distintas formulaciones.
Inteligencia empresarial
En el ámbito de la inteligencia empresarial (business intelligence), el aprendizaje automático puede ayudar a analizar los datos de una empresa, detectar patrones y anomalías y realizar predicciones. De este modo, es posible evaluar mejor, por ejemplo, la evolución de las ventas, la demanda, el comportamiento de los clientes o determinados riesgos. El aprendizaje profundo resulta especialmente útil cuando es necesario procesar grandes volúmenes de datos o información no estructurada, como textos, imágenes, voz o datos de comportamiento complejos.